マナミです。
AIであらゆる情報が瞬時に手に入る時代になりました。そんな今だからこそ、「人の生の声」や「リアルな一次体験」に、これまで以上の価値が生まれていると感じています。
今回は、AI時代において音声配信がいかに重要か、そして喋ったことを起点にコンテンツを広げていく方法についてお話しします。
結論から言うと「まず喋ること」が、最も効率的で、かつ人の心に届くコンテンツ作りの第一歩です。
音声配信をこれから始めたい人、そしてすでに始めている人にも役立つヒントをお伝えしますので、ぜひ最後までお付き合いください。
なぜ今、音声配信が重要なのか?
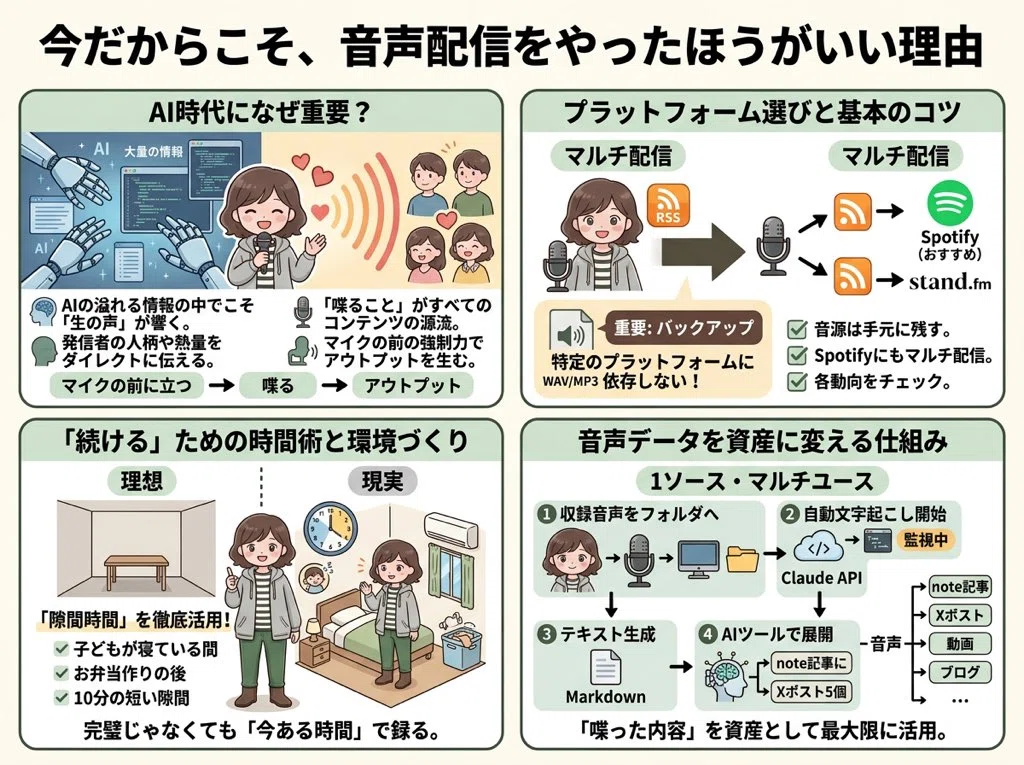
AIが書いた記事、生成された画像が溢れる中で、「この人は何を考え、どんな体験をしてきたんだろう?」という、人の内面に触れたいという欲求はますます高まっています。その中で、音声配信は発信者の人柄や熱量、考え方をダイレクトに伝えられる、非常に強力なメディアです。
今の私の仕事は「喋らないと何も始まらない」と言っても過言ではありません。音声の文字起こしからnoteの記事を作り、メンバーシップの記事を書き、Xのポストを考える。すべてのコンテンツの源流が「喋ること」にあるんです。
このスタイルには大きなメリットがあります。それは「ネタがなくても、とにかくマイクの前に立てばアウトプットが生まれる」という強制力です。今日何を発信しようかと悩んだら、まずは喋ってみる。そのプロセス自体が、コンテンツ制作の第一歩になるのです。AI時代だからこそ、この「生身の人間の声で語る」という行為が、他にはない価値を生み出すと確信しています。
始める前に知っておきたいプラットフォーム選びと基本のコツ
音声配信を始めよう、あるいは続けていこうと思ったとき、どのプラットフォームで配信するかは重要なポイントです。
最近、いくつかのプラットフォームの動きを見ていると、少し気になる点も出てきました。例えば、特定のプラットフォームはユーザーの伸びが鈍化しているように感じたり、リアルイベントに注力し始めていて、ユーザーが本当に求めている方向性と少しずれているのでは?と感じることもあります。
だからこそ、今一番伝えたいのは「特定のプラットフォームだけに依存せず、必ず自分で音源を持っておくこと」です。
その上で、私が今最も可能性を感じているのはSpotifyです。音楽も聴けるしビデオポッドキャストも楽しめる。音楽のおすすめの精度が高いのもあって音楽アプリとしてもよく使用しています。
またRSSフィードを使って複数プラットフォームにも配信する「マルチ配信」という形を取ることを強くおすすめします。意外とこのマルチ配信をしている人はまだ少ないんですよね。今までと変わらない労力で自動的により多くの人に届けるチャンスが広がるので、色んな人にやって欲しいなと思います。
つまり音声配信で生き残るために、押さえておきたいポイントは以下の通りです。
音源は必ず自分の手元にバックアップとして残しておく
マルチ配信の仕組みを作る
各プラットフォームの動向を定期的にチェックし、柔軟に対応する
一つの場所に固執せず、自分の発信という大切な資産を守りながら、多くの人に届ける工夫をしていきましょう。
音声配信を「続ける」ための時間術と環境づくり
スマホ一つで始められる手軽さが魅力の音声配信ですが、多くの人がぶつかるのが「収録時間をどう確保するか」という壁です。特に、私のように小さい子どもがいる家庭では、静かな環境で集中して話す時間を確保するのは至難の業です。
我が家も、子どもたちが保育園に行く前の朝のドタバタした時間、お弁当を作り終えた直後など、本当にわずかな隙間時間を見つけて収録しています。子どもたちがリビングでテレビを見ている間に、自分は寝室にこもってマイクを握りしめている、なんてこともしょっちゅうです。
テキストコンテンツなら場所を選ばず書けますが、音声はそうはいきません。「収録する」という行為のために、物理的な時間と場所を確保する必要がある。これが、音声配信の継続における最大のハードルかもしれません。
だからこそ、「完璧な環境を待つのではなく、今ある隙間時間でとにかく録る」というマインドが大切になります。たとえ10分の短い時間でも、その積み重ねが大きなコンテンツ資産になっていくのです。
喋るだけでは終わらない。音声データを資産に変える仕組みづくり
音声配信の真価は、喋った内容を「1ソースマルチユース」の起点にできる点にあります。つまり、一つの音声データを元に、ブログ記事、SNS投稿、動画コンテンツなど、様々な形に展開していくのです。この「喋ったことを資産として蓄積し、活用する仕組み」を作ることが、AI時代のコンテンツ発信において非常に重要になります。
まず、文字起こしは難しく考える必要はありません。今や「iPhoneのボイスメモで録音すれば、自動でかなり精度の高い文字起こしが生成される」ので、まずはそれをコピー&ペーストしてブログ記事用に整えるだけでも十分です。
さらに一歩進んだ私の現在のワークフローは、少し自作の仕組みを取り入れています。
収録した音声データをPCの特定のフォルダに入れる。
フォルダが監視されていて、データが入ると自動で文字起こしが始まる(これはClaudeのAPIなどを利用して作りました)。
文字起こしされたテキストが、マークダウン形式で別のフォルダに保存される。
そのテキストをAIライティングツールで開き、「noteの記事にして」「Xのポストを5個作って」と指示を出して、各コンテンツに展開していく。
この仕組みも、1ヶ月前は違うツールを使っていましたし、また新しい便利なツールが出てくればどんどん変わっていくでしょう。大切なのは「いかに楽をして、喋った内容を最大限に活用できるか」を常に考え、自分のやり方をアップデートし続けることです。
まだ音声配信を始めていない人は、ぜひ今日から。stand.fmもSpotifyも審査なしで始められます。
そして、すでに頑張っている人は、その音声をどう資産に変えていくか、という視点を持って仕組みの部分を整えてみてください。私も引き続き色々なAIツールの情報をキャッチしながらアップデートしていこうと思います。
この記事のまとめ
AI時代だからこそ、人の生の声で語るコンテンツに価値がある
「まず喋る」ことが、最も効率的なコンテンツ作りの第一歩
特定のプラットフォームに依存せず、音源は必ず自分で持っておく
RSSフィードを使ったマルチ配信で、同じ労力でより多くの人に届く
完璧な環境を待たず、隙間時間でとにかく録るマインドが大切
音声データを「1ソースマルチユース」で記事・SNS・動画に展開する仕組みをつくる
【メンバーシップ限定】音声配信を頑張りたい人を応援!配信に関する便利ツールや、記事が人気です
音声配信をもっと頑張りたいという人のために、音声配信のネタ出しツールや、その他RSS配信に関する記事などを更新中です!
私のnoteで最も人気のある、「音声配信からnote記事にするコツ」なども、通常500円の有料記事ですがメンバーシップの方は読み放題対象にしています。
この記事はnoteに掲載した記事を転載しています。